Las cuatro empresas más grandes de inteligencia artificial acordaron respetar una misma señal en el archivo robots.txt para que un sitio pueda negarse a que su contenido entrene sus modelos. Cada una la adoptará a su ritmo, y la señal todavía no es un estándar oficial.
Lo que debes saber
- Un sitio podrá excluir su contenido del entrenamiento de IA con una sola regla en robots.txt, en lugar de bloquear a cada empresa por separado.
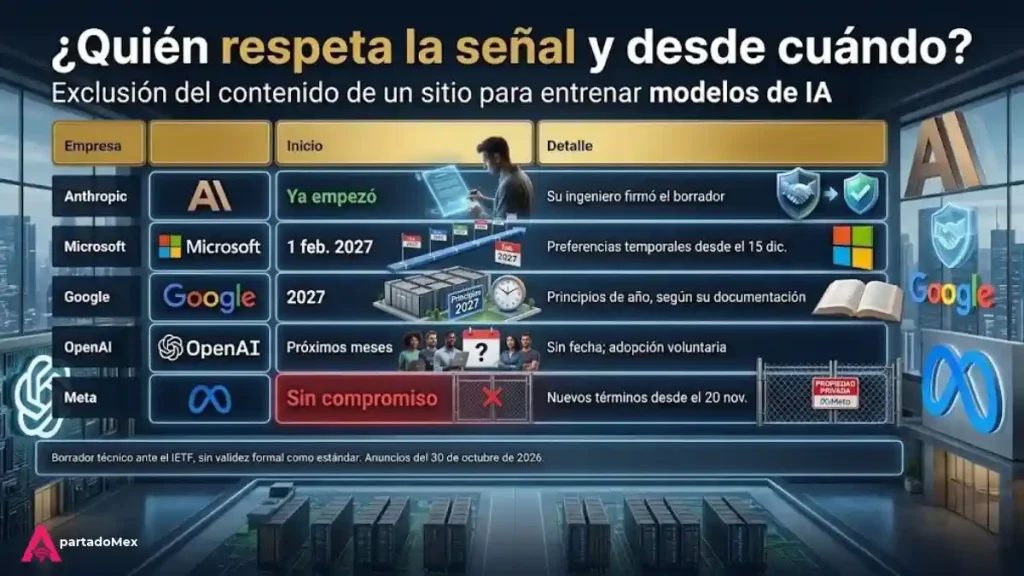
- Anthropic ya empezó a aplicarla; Microsoft la respetará desde el 1 de febrero de 2027 y Google, en 2027.
- OpenAI la aplicará “en los próximos meses”, sin fecha.
- La señal limita el uso del contenido para entrenar, no el rastreo ni la aparición en buscadores.
- Meta no se comprometió a respetarla.
Hasta ahora, un medio, una tienda en línea o un blog que no quería que su contenido sirviera para entrenar modelos de inteligencia artificial tenía que conocer el nombre del rastreador de cada empresa y bloquearlo uno por uno. El 30 de octubre, Google, Microsoft, OpenAI y Anthropic anunciaron que respetarán una misma señal para expresar esa preferencia.
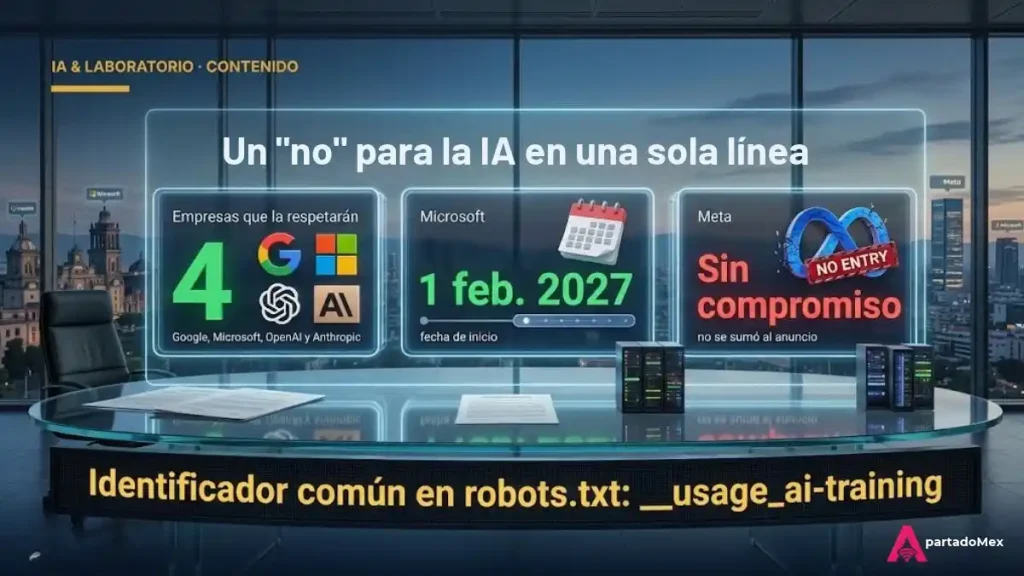
La propuesta funciona en el archivo robots.txt, el que usan los sitios para dar instrucciones a los rastreadores. En lugar del nombre de un robot, se escribe un identificador común, __usage_ai-training, seguido de la regla que se quiera aplicar: bloquear todo el sitio o dejar abiertas algunas secciones, como una sala de prensa.
Cuándo empieza a contar
El calendario no es parejo. Anthropic, cuyo ingeniero firmó el borrador técnico, dice que ya empezó a aplicarla. Microsoft fijó el 1 de febrero de 2027 y abrirá antes, el 15 de diciembre, unas preferencias temporales en sus herramientas para administradores de sitios. Google habla de principios de 2027. OpenAI dijo que lo hará en los próximos meses y aclaró que la adopción es voluntaria.
La señal sólo controla el uso para entrenamiento. No impide que un robot visite la página ni saca al sitio de los resultados de búsqueda. Microsoft lo dejó claro: excluirse no garantiza ni quita visibilidad, tráfico o pago. Y quien no escriba nada en su archivo no está diciendo ni sí ni no.
Lo que todavía no resuelve
El documento técnico es un borrador individual presentado ante el grupo del IETF que trabaja en preferencias para IA, y el propio organismo aclara que no tiene validez formal como estándar. Tampoco obliga a nadie más. Meta, que retrasó al 20 de noviembre sus nuevos términos para rastrear sitios ligados a cuentas comerciales de Facebook e Instagram, no se comprometió a respetarla.
Para los negocios mexicanos con presencia en línea, la decisión tiene un costo y un beneficio. Excluirse protege el contenido propio, pero también puede reducir la presencia de la marca en las respuestas de los asistentes de IA, que cada vez más personas usan para buscar productos, precios y noticias.
Cuatro empresas, cuatro calendarios Una regla, cero obligación. La señal funciona sólo con quien decida respetarla. Si administras un sitio, vale la pena decidir ahora qué quieres permitir y revisar tu robots.txt antes de febrero.
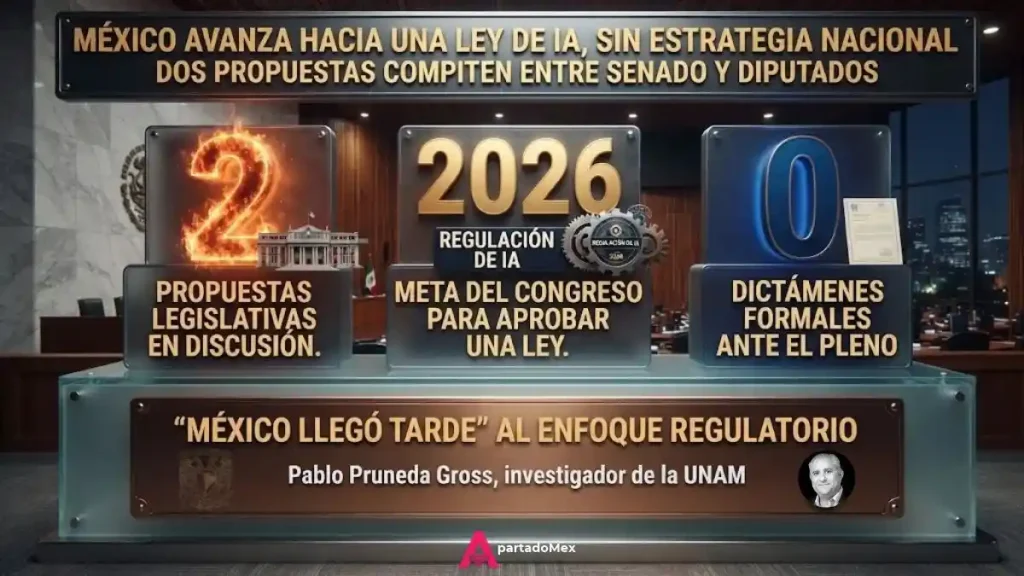
Las presiones regulatorias que ya enfrentan estas empresas en Estados Unidos se explicaron en La FTC pone la lupa sobre OpenAI y Anthropic, y el estado de la regulación en México, en México avanza hacia una ley de IA, sin estrategia nacional.
¿Qué es la señal común contra el entrenamiento de IA?
Una regla en el archivo robots.txt, con el identificador __usage_ai-training, para indicar que el contenido de un sitio no debe usarse para entrenar modelos.
¿Qué empresas la respetarán?
Google, Microsoft, OpenAI y Anthropic. Meta no se comprometió.
¿Desde cuándo aplica?
Anthropic ya la aplica; Microsoft desde el 1 de febrero de 2027; Google en 2027; OpenAI en los próximos meses.
¿Saca a mi sitio de los buscadores?
No. Sólo expresa una preferencia sobre el entrenamiento; no bloquea el rastreo ni la aparición en resultados.
¿Es obligatoria?
No. Es un borrador técnico sin validez formal como estándar y su adopción es voluntaria.
Actualizado: 1 de noviembre de 2026, 9:00 h. – Datos al corte: anuncios de Google, Microsoft, OpenAI y Anthropic (30 oct.) y borrador draft-kelley-aipref-training-preference-signal-00 en el IETF, (31 oct.). – Lo próximo: la apertura de las preferencias temporales en Bing Webmaster Tools, el 15 de diciembre; la entrada en vigor de los términos de Meta para rastrear sitios de anunciantes, el 20 de noviembre.